Wiki · Нейросети и AI-поиск
LLM (большая языковая модель)
LLM (Large Language Model, большая языковая модель) – это нейросеть, которую обучили на огромном объёме текстов предсказывать следующий фрагмент текста. На LLM работают ИИ-ассистенты вроде ChatGPT, Claude, YandexGPT и GigaChat.
В разговорах с подрядчиками слова «нейросеть», «ИИ», «GPT» и «модель» часто смешивают. LLM – общее название технологии, а GPT, Claude и GigaChat конкретные модели разных компаний. Если понять, как такая модель устроена, становится ясно, почему она пишет гладко и уверенно и почему при этом может ошибаться.
Как LLM собирает ответ из токенов
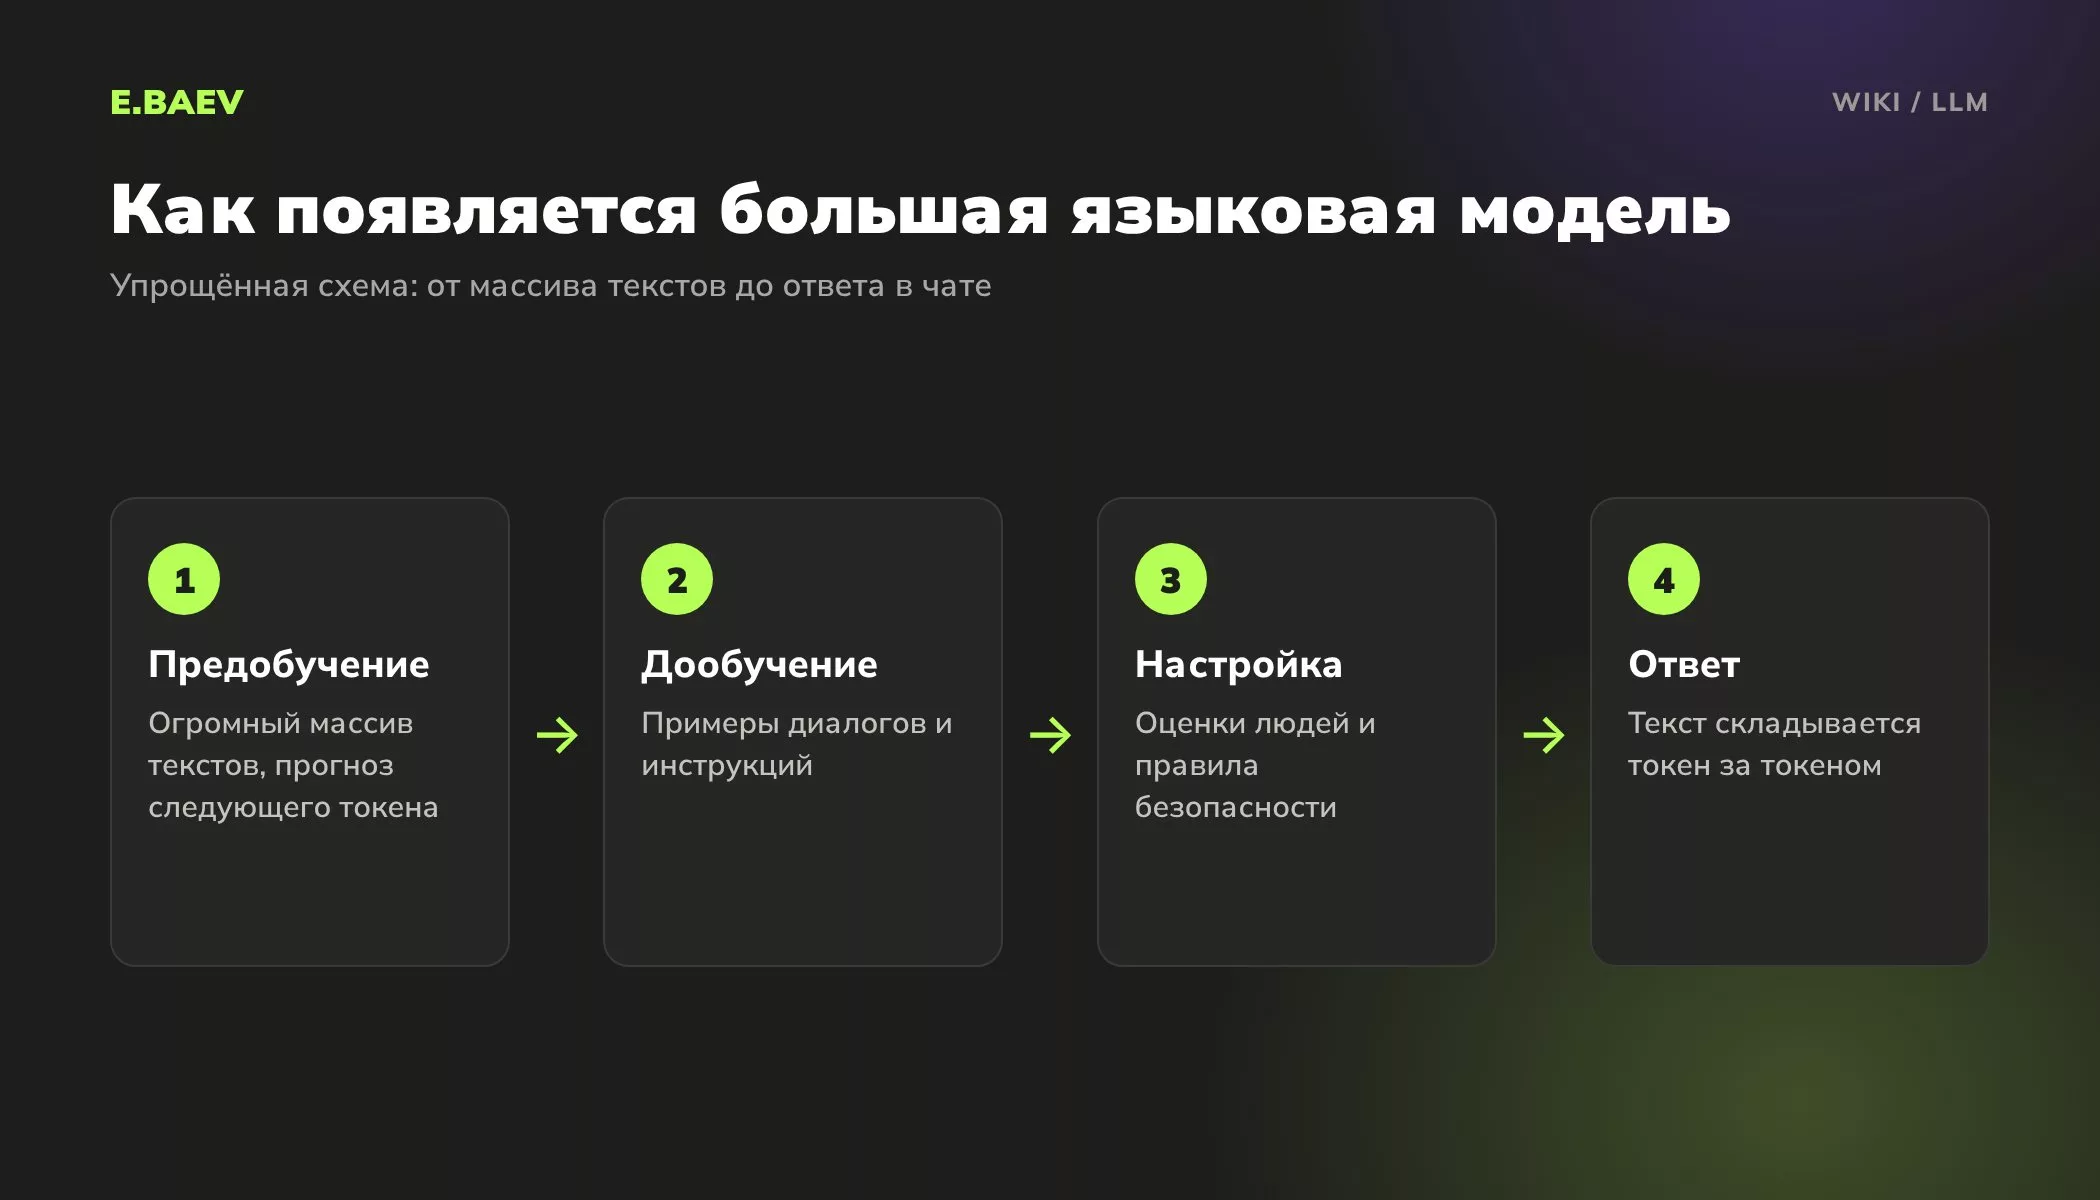
Модель не хранит готовые ответы. Она видит текст как цепочку токенов (кусочков слов) и на каждом шаге выбирает, какой токен вероятнее всего пойдёт дальше. Так, токен за токеном, складывается ответ. Условный пример, реальное деление зависит от модели:
«Купить диван в Красноярске»
→ [Куп][ить][ диван][ в][ Крас][ноя][рск][е]
Почти все современные LLM построены на архитектуре «трансформер», которую исследователи Google описали в 2017 году. «Большой» модель называют из-за числа параметров (их миллиарды) и объёма текстов, на которых её учили.
Сколько текста модель видит за раз, задаёт контекстное окно. Оно тоже измеряется в токенах. У старших моделей Claude, например, на октябрь 2026 года окно до 1 млн токенов: в один запрос помещается толстый договор или выгрузка за год.
Что LLM умеет, а в чём ошибается
- Писать, сокращать и переводить тексты, менять стиль.
- Разбирать документы: найти в договоре сроки, вытащить реквизиты из счёта.
- Сортировать входящие заявки и письма по темам.
- Писать и проверять программный код.
- Гарантировать точность фактов. Модель может уверенно выдумать цифру, цитату или ссылку, это называют галлюцинацией.
- Знать то, что случилось после даты обучения, если ей не дали поиск или ваши документы.
Какие бывают LLM
| Группа | Примеры | Как подключают |
|---|---|---|
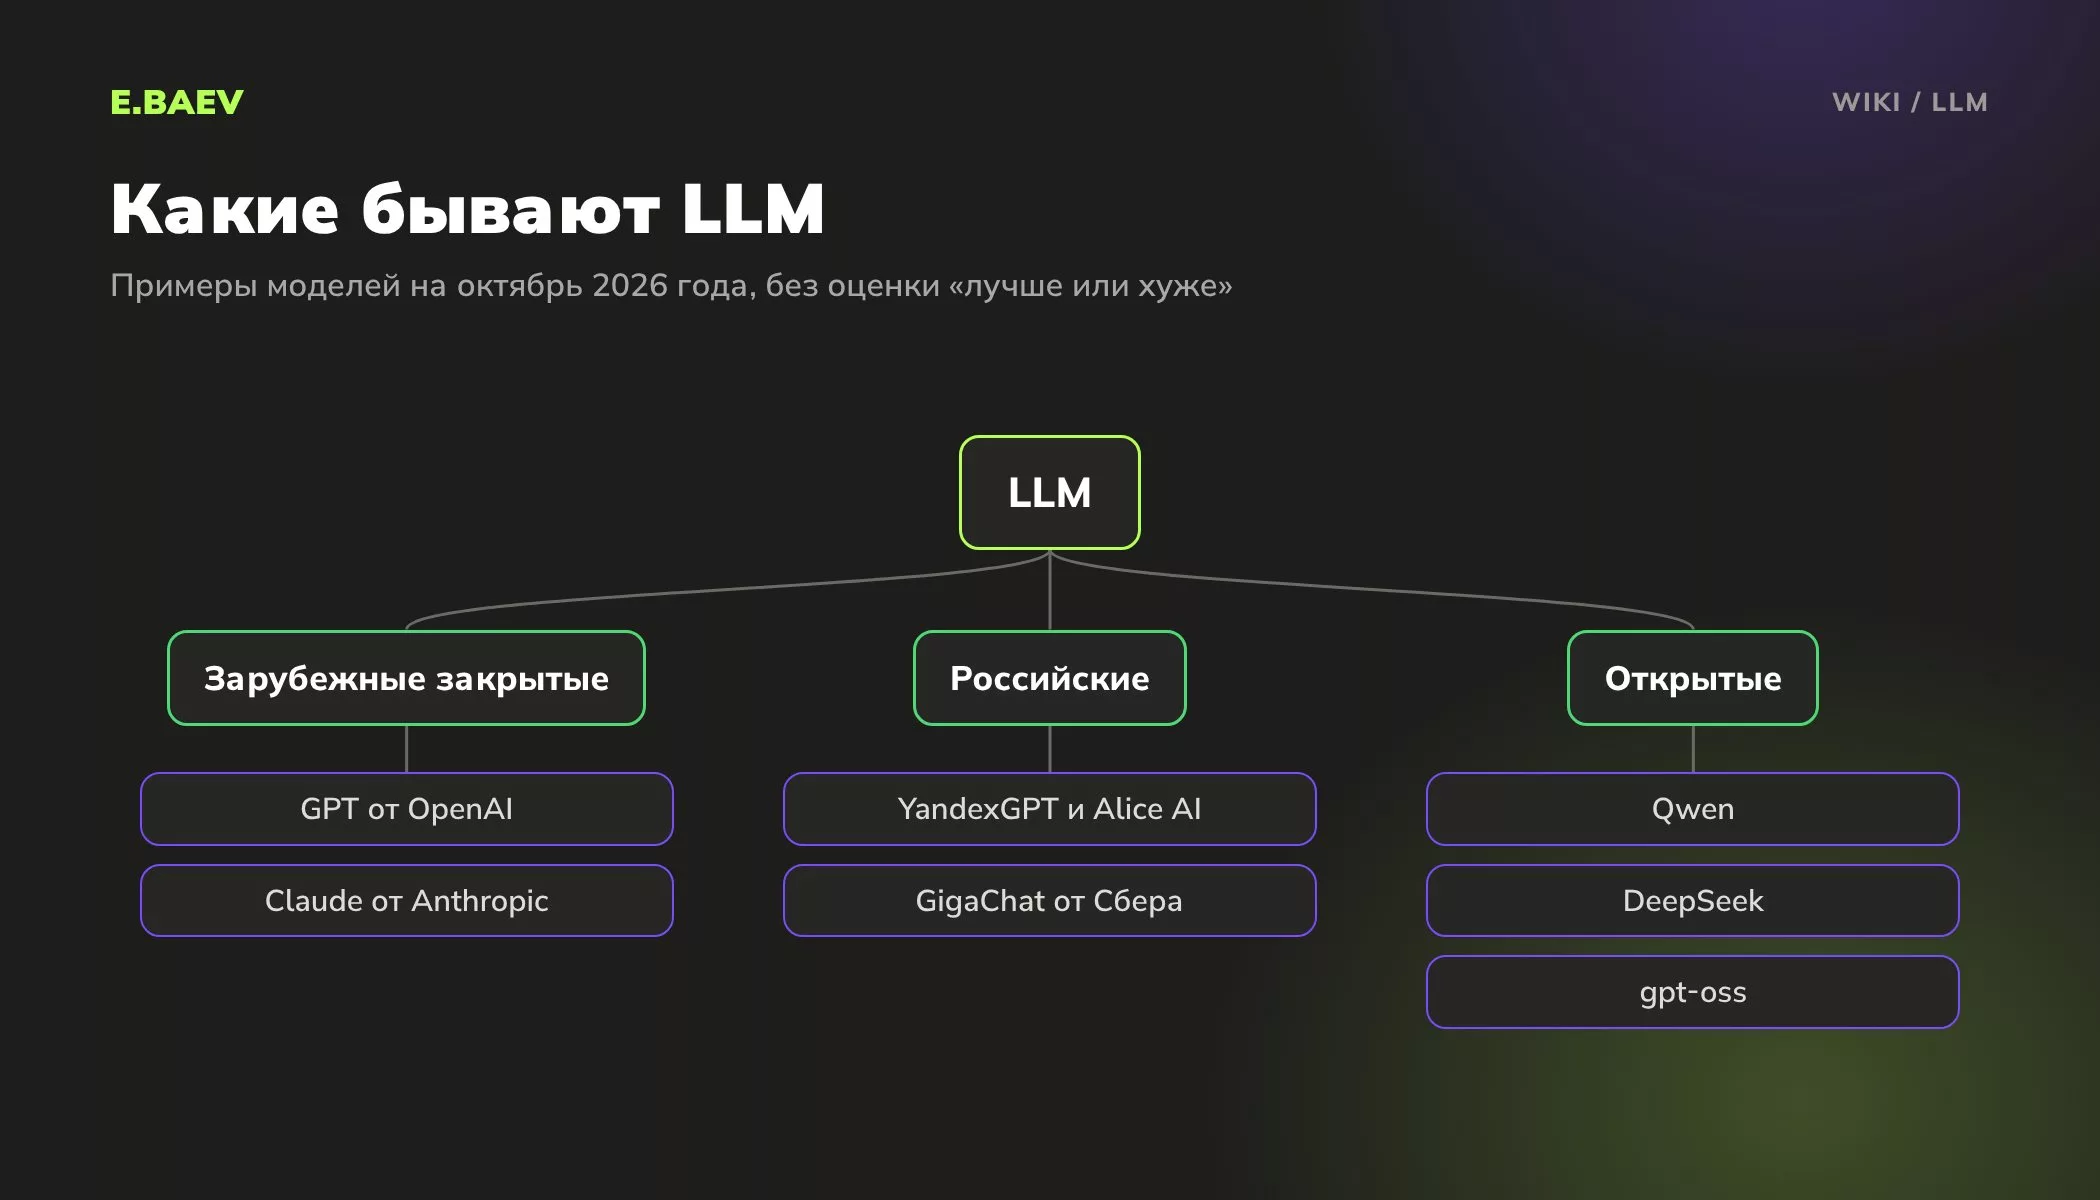
| Зарубежные закрытые | GPT (OpenAI), Claude (Anthropic) | Чат или API разработчика модели |
| Российские | YandexGPT и Alice AI LLM (Яндекс), GigaChat (Сбер) | Чат или API в облаке разработчика |
| Открытые | Qwen, DeepSeek, gpt-oss | Свой сервер или облако, например Yandex AI Studio |
Сравнивать их по принципу «какая умнее» бесполезно: модели обновляются несколько раз в год, и результат зависит от задачи. Выбирают по тесту на своих примерах, условиям работы с данными и доступности в стране. Двум зарубежным моделям посвящены отдельные статьи: ChatGPT и Claude. На октябрь 2026 года Россия не входит в списки поддерживаемых стран ни у OpenAI, ни у Anthropic.
Локальные LLM
Открытые модели можно скачать и запустить на своём сервере. Тогда документы и переписка не уходят к внешнему сервису, а работа не зависит от чужих условий доступа. Цена вопроса другая: нужны серверы с видеокартами и специалист, который их поддерживает. Небольшие открытые модели хорошо справляются с простыми задачами вроде сортировки заявок, а для сложных рассуждений обычно берут модели покрупнее. Есть и промежуточный вариант: открытые модели в российском облаке. В Yandex AI Studio на октябрь 2026 года доступны, например, Qwen, DeepSeek и gpt-oss.
Как бизнес использует LLM
Самый простой вариант: сотрудники работают в чате ассистента. Подробнее о таких сервисах в статье ИИ-ассистенты. Следующий шаг: модель подключают через API к сайту или CRM, и она отвечает клиентам по вашей базе знаний. Этот подход называют RAG: система сначала находит нужные фрагменты в документах компании и только потом передаёт их модели.
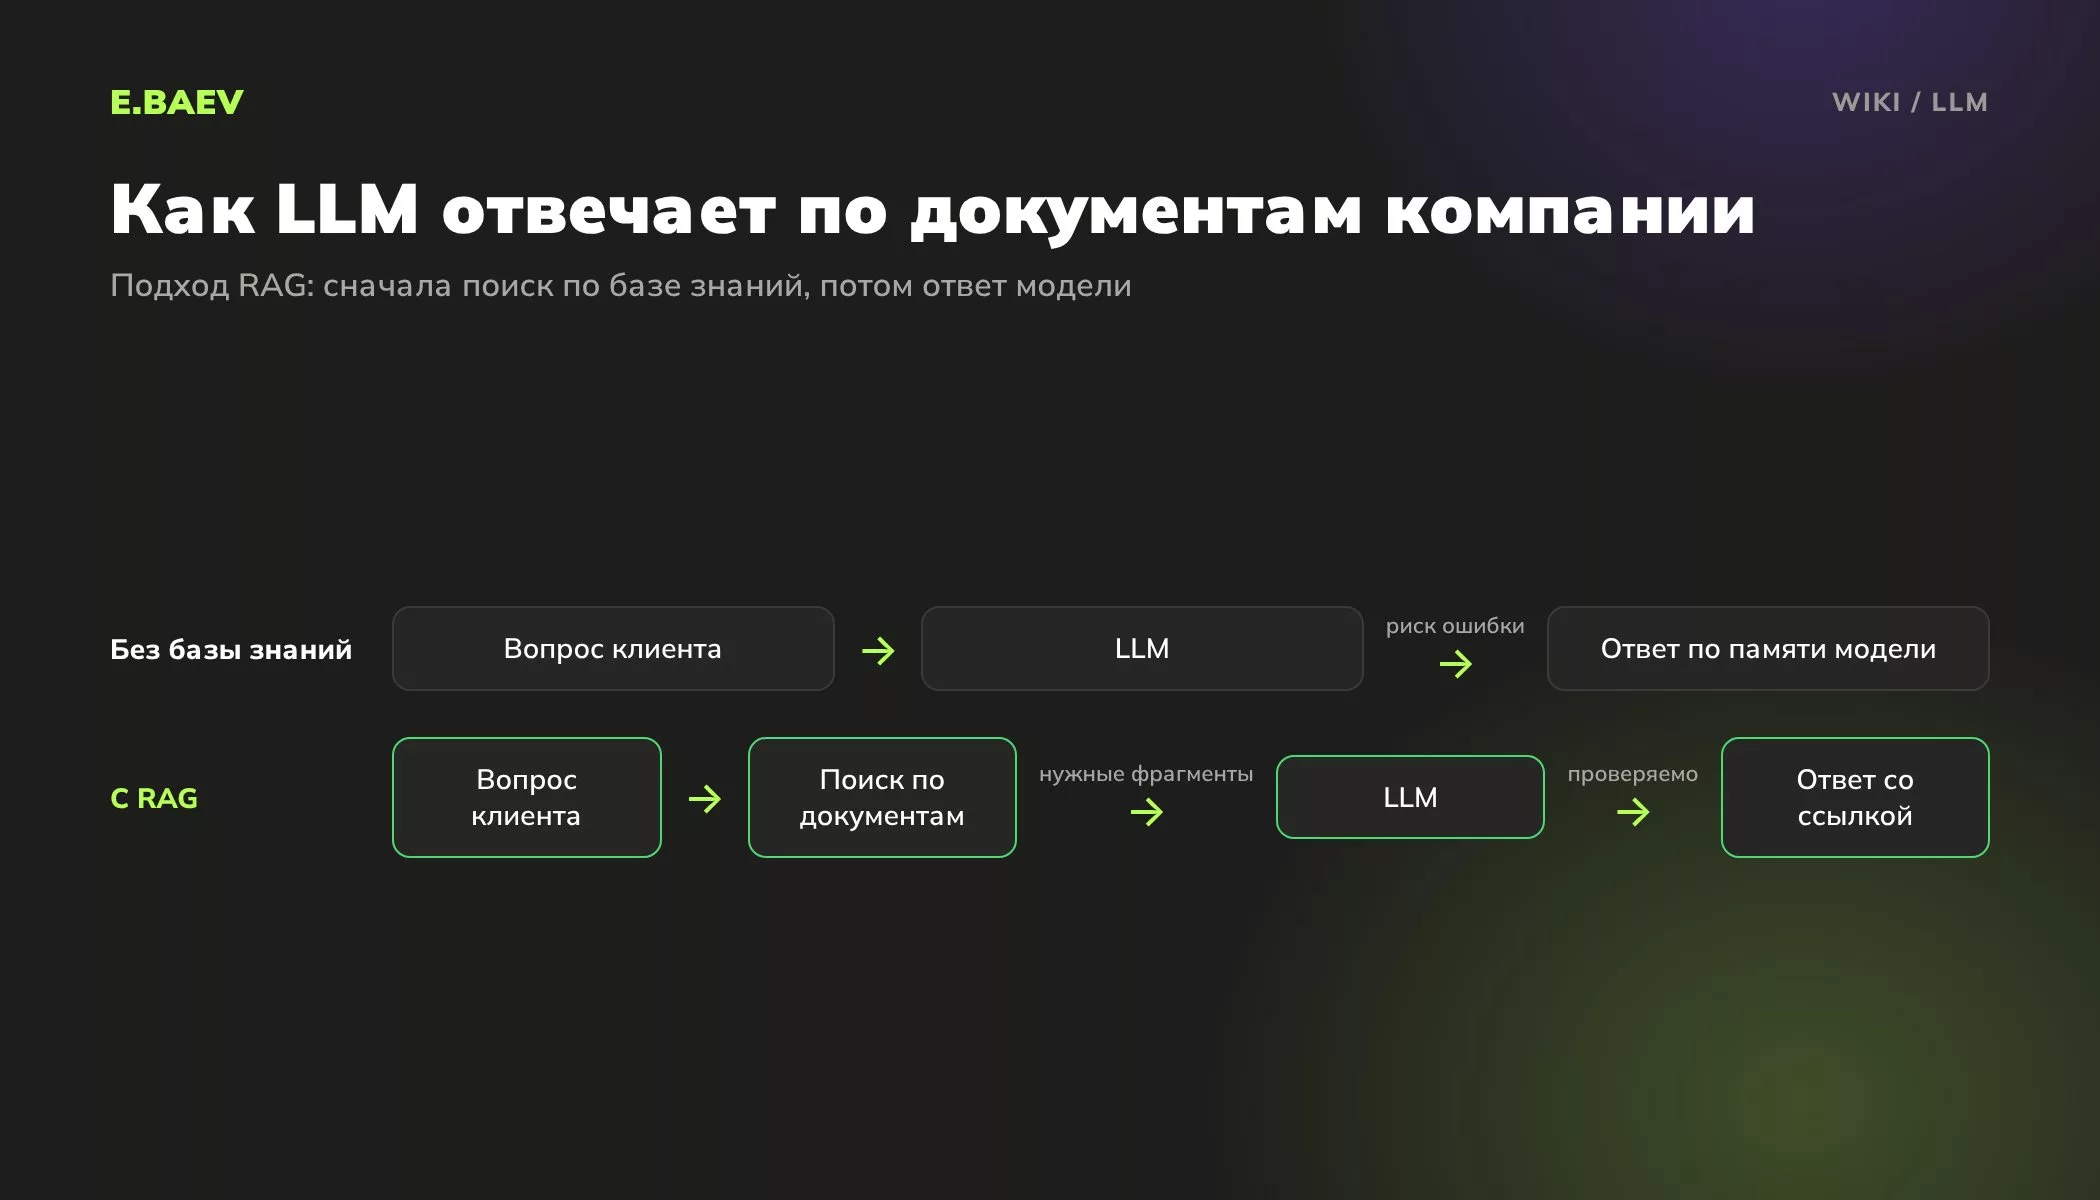
Ещё шаг дальше идут агенты: модель сама вызывает инструменты. Она может найти новые заявки на площадках, завести по ним сделки в CRM и подготовить черновик ответа менеджеру. Сами мы работаем с Claude и GPT над кодом, текстами и данными Метрики, и итог любой такой работы проверяет человек.
LLM изменили и поиск: Яндекс и Google показывают ответы нейросети прямо в выдаче, об этом статья AI Overview и Нейро. Как сделать сайт источником для таких ответов, разбираем в статье GEO.
Что спросить у подрядчика
Если вам предлагают внедрить «нейросеть», попросите ответить на несколько вопросов письменно:
- Какая модель используется и чья она: зарубежная, российская или открытая на своём сервере?
- Какие данные уходят в модель и где их обрабатывают?
- Можно ли заменить модель без переделки всей системы?
- Как проверяют качество ответов и кто разбирает ошибки?
Почему внедрение LLM не даёт эффекта
- Ждать от модели точности справочника. Ответы с цифрами, ценами и ссылками на законы проверяет человек.
- Выбирать модель по рейтингам и новостям. Решает тест на ваших реальных письмах, заявках и документах.
- Отправлять персональные данные клиентов во внешнюю модель, не оценив требования закона 152-ФЗ.
- Не мерить результат. До запуска запишите, сколько времени уходит на задачу сейчас, иначе эффект внедрения не с чем сравнить.
Подобрать LLM под задачу, подключить её к сайту, CRM или базе знаний и настроить проверку ответов помогаем при внедрении ИИ в бизнес. Если нужен помощник, который сам выполняет шаги процесса, смотрите создание ИИ-агентов. Чтобы сайт попадал в ответы нейросетей в поиске, работаем с ним в SEO-продвижении.
Выбор, обучение и запуск LLM
Какая LLM лучше: GPT, Claude или GigaChat?
Лучшей для всех задач нет: новые версии выходят по нескольку раз в год, и вчерашний рейтинг быстро устаревает. Сравнивают на своих данных: берут реальные письма, заявки и документы, прогоняют через две-три модели и смотрят на точность и скорость. Российской компании стоит учесть и доступ: GPT и Claude официально в России не работают.
Почему LLM уверенно придумывает факты?
Она подбирает самое вероятное продолжение текста, а не достаёт ответ из базы. Если точных данных нет, модель тем же уверенным тоном сочинит правдоподобную цифру, цитату или ссылку. Поиск и доступ к вашим документам снижают число таких ошибок, но проверку человеком не отменяют.
Чем LLM отличается от ИИ-агента?
LLM только пишет текст в ответ на запрос. Агент – это программа вокруг модели, которая сама вызывает инструменты: ищет в базе, создаёт сделку в CRM, отправляет письмо. Модель решает, какой шаг сделать дальше, а программа его выполняет.
Что нужно, чтобы запустить LLM на своём сервере?
Открытая модель, сервер с видеокартами и специалист, который будет его поддерживать. Из моделей подойдут, например, Qwen, DeepSeek или gpt-oss. Для сортировки заявок и других простых задач хватит небольшой модели, для сложных рассуждений нужна крупнее и железо мощнее. Если своего сервера нет, те же модели можно взять в российском облаке.
Как научить LLM отвечать по документам компании?
Чаще всего модель не обучают, а подключают к базе знаний через RAG: система находит нужные куски документов и передаёт их модели вместе с вопросом. Если нужен особый стиль или формат ответов, готовую модель дообучают на ваших примерах, такую возможность дают, например, в Yandex AI Studio. Учить свою LLM с нуля бизнесу незачем.
Как LLM связана с ML и нейросетями вообще?
Это вложенные понятия. Машинным обучением (ML) называют все методы, которые учатся на данных, нейросети один из них, а LLM это нейросеть, обученная на текстах. Сеть для распознавания фото или синтеза речи тоже нейросеть, но не LLM.
Когда появились большие языковые модели?
Основа появилась в 2017 году: тогда в Google описали архитектуру «трансформер», на которой построены почти все нынешние модели. Массово о LLM заговорили после 30 ноября 2022 года, когда OpenAI открыла ChatGPT.
Какие LLM официально работают в России?
Российские YandexGPT и Alice AI LLM от Яндекса и GigaChat от Сбера: их используют в чате и подключают по API в облаке разработчика. Ещё вариант: открытые модели вроде Qwen, DeepSeek и gpt-oss на своём сервере или в Yandex AI Studio. У OpenAI и Anthropic, разработчиков GPT и Claude, России в списках поддерживаемых стран на октябрь 2026 года нет.
Источники
- Vaswani и соавторы, «Attention Is All You Need» (Google, 2017)
- Yandex AI Studio: документация, модели генерации текста
- GigaChat: документация для разработчиков, модели
- Anthropic: документация, обзор моделей Claude
- OpenAI: анонс семейства GPT-5.6
См. также: ИИ-выдача, llms.txt, Zero-click поиск.
Остались вопросы по теме «LLM (большая языковая модель)»?
Напишите нам в Telegram или MAX. Ответит специалист, который отвечает за эту тему, или руководитель проектов в рабочее время.
 Отвечает по темеЕвгений БаевРуководитель
Над статьёй работали
Услуги
Услуги по теме
Проверим ваш сайт бесплатно
Экспресс-аудит за 24 часа: скорость, индексация, мета-теги, коммерческие факторы и цели Метрики.