Wiki · Технологии разработки
Apache Kafka
Apache Kafka – это платформа потоковой обработки событий с открытым кодом: она принимает события от одних систем, надёжно хранит их и раздаёт другим системам в реальном времени. Проект развивает Apache Software Foundation, лицензия Apache 2.0.
Событие здесь означает любой факт с отметкой времени: покупатель положил товар в корзину, курьер отметил доставку, датчик прислал температуру. Пока таких фактов сотни в день, их спокойно пишут в обычную базу. Когда их миллионы и каждое нужно сразу пяти разным сервисам, нужна прослойка, которая всё примет и никого не заставит ждать. Kafka и есть такая прослойка.
Топики, партиции и журнал, который не стирается после чтения
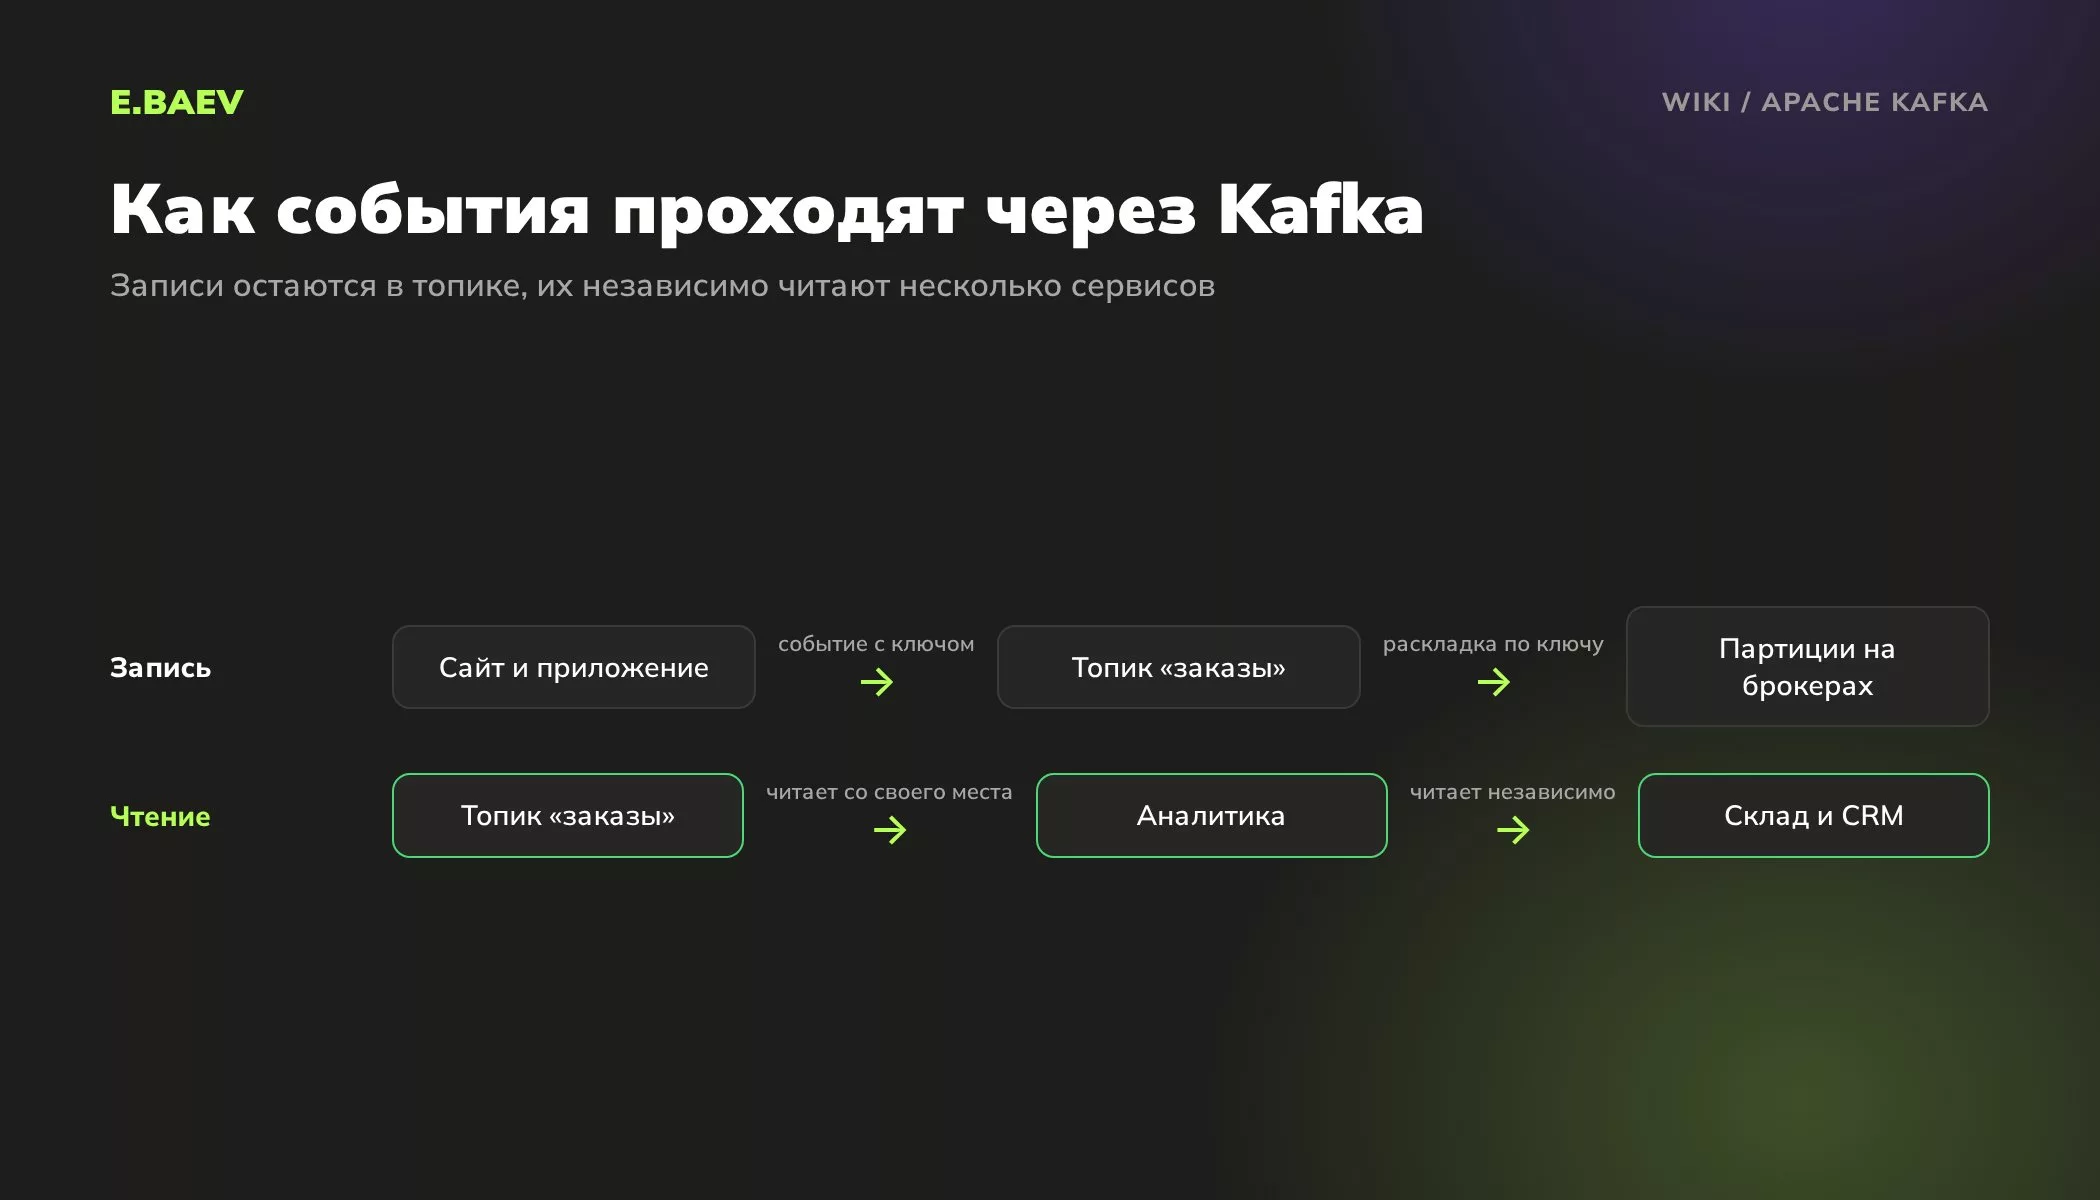
Внутри Kafka события лежат в топиках. Топик похож на папку для событий одного вида: «заказы», «клики», «оплаты». Его делят на партиции и раскладывают по нескольким серверам (брокерам), чтобы нагрузка распределялась.
Главное отличие от привычной очереди: прочитанное событие не удаляется. Документация Kafka прямо говорит, что события не стираются после потребления, а сколько их хранить, задают отдельно для каждого топика. Поэтому одни и те же события может независимо читать аналитика, склад и рассылка, а новый сервис может перечитать историю с начала.
Порядок Kafka гарантирует только внутри партиции: события с одинаковым ключом, например номером заказа, попадают в одну партицию, и любой читатель увидит их в том порядке, в каком их записали. Между разными партициями порядок не гарантирован, это стоит учитывать в задачах вроде смены статусов заказа.
Вокруг ядра есть два инструмента. Kafka Connect постоянно переносит данные между Kafka и другими системами, например базами данных. Kafka Streams это библиотека для Java, на ней пишут обработку потока: агрегаты, объединения, фильтры. С версии 4.0 Kafka работает только в режиме KRaft, без отдельного кластера ZooKeeper, поэтому старые кластеры перед обновлением приходится переводить.
Где Kafka окупается
- Поток событий от сайта, приложения или датчиков, который нужно считать на лету: аналитика в реальном времени, антифрод, мониторинг.
- Много систем читают одни и те же данные: интернет-магазин, склад, CRM, хранилище для отчётов. Kafka избавляет от паутины прямых интеграций каждого с каждым.
- Нужно хранить историю событий и перечитывать её: пересчитать отчёт, запустить новый сервис на старых данных.
- Перенос данных из рабочих баз в аналитические, например в ClickHouse, почти без задержки.
В документации Kafka среди примеров использования названы обработка платёжных транзакций в реальном времени, отслеживание транспорта и грузов, сбор данных с IoT-датчиков. Объёмы у таких систем другие, чем у сайта компании.
Почему для обычного сайта Kafka избыточна
Сайт услуг или интернет-магазин на 1С-Битрикс отправляет заявку в CRM, письмо клиенту и запись в отчёт. Это десятки событий в час, и с ними справляется обычный обмен через API или фоновая очередь на Redis. Kafka в таком проекте добавит кластер, который нужно разворачивать, обновлять, мониторить и резервировать, и специалиста, который в нём разбирается. Пользы при этом почти не будет.
Kafka или RabbitMQ: какую задачу решает каждый
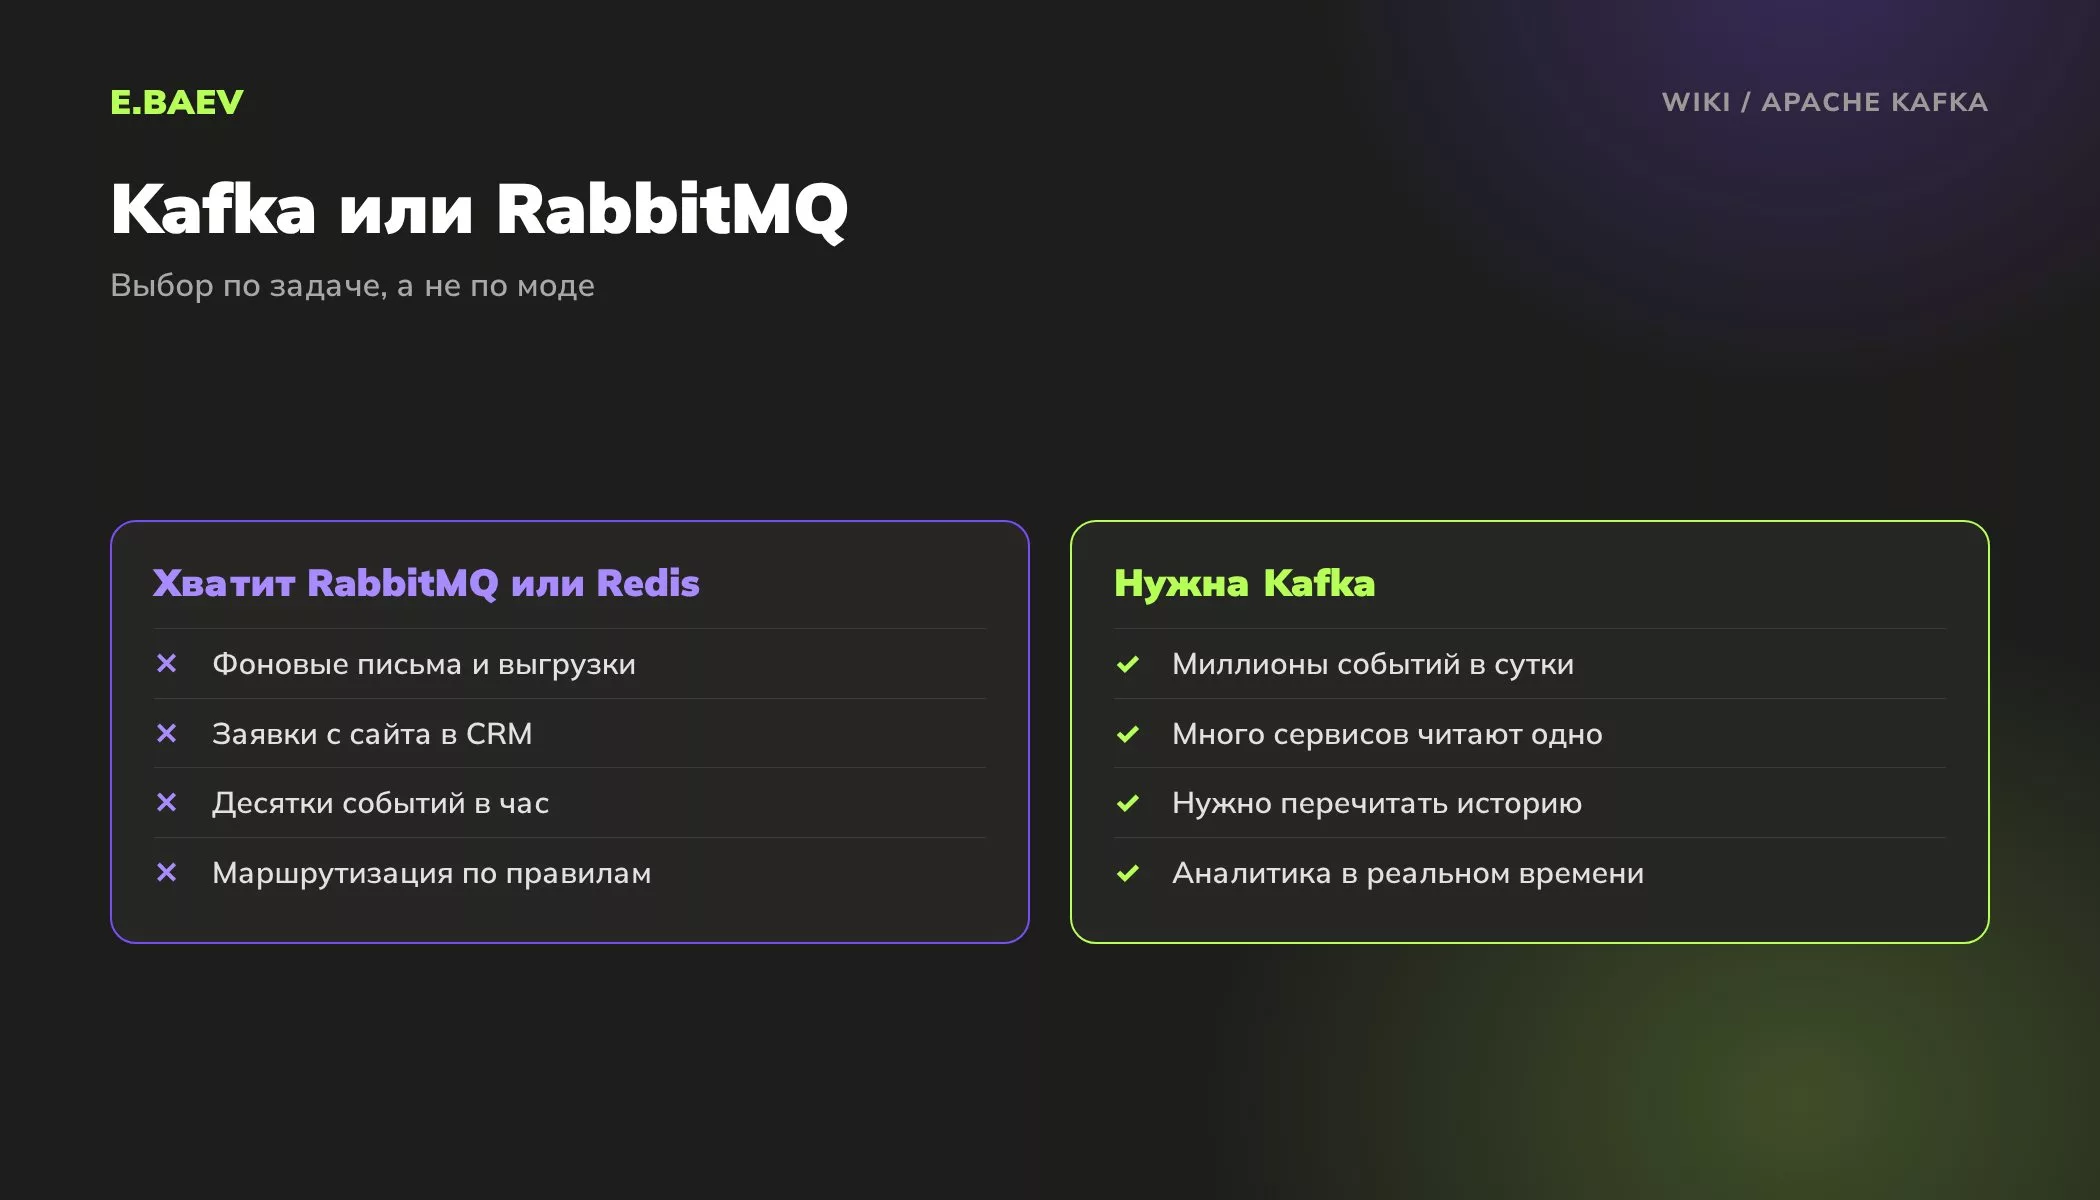
Их часто ставят рядом, но устроены они по-разному. В RabbitMQ сообщение – это отдельное задание: брокер сам решает, кому его отдать, а после подтверждения удаляет. В Kafka сообщение становится записью в общем журнале, маршрут выбирает отправитель, а запись живёт до конца срока хранения.
| Задача | Kafka | RabbitMQ |
|---|---|---|
| Фоновые задания: письма, генерация PDF, выгрузки | избыточна | подходит |
| Сложная маршрутизация сообщений по правилам | маршрут задаёт отправитель | маршрутизация внутри брокера |
| Большой поток событий для нескольких читателей | подходит | есть режим потоков (streams) |
| Перечитать историю событий за месяц | штатно, по сроку хранения | только в режиме потоков |
| Обработка потока на Java (Kafka Streams) | подходит | нет аналога |
Сами разработчики RabbitMQ на странице сравнения советуют начинать с RabbitMQ и добавлять Kafka, когда понадобится то, что умеет только она: сжатие журнала, многоуровневое хранение или Kafka Streams. Это позиция одной стороны, но с ней трудно спорить на небольших проектах.
Что Kafka добавляет в проект заказчика
Kafka живёт отдельно от сайта: её запускают на своих серверах, часто в Docker или Kubernetes, или берут управляемый сервис у облачного провайдера. Клиенты для неё есть на Java, Python, Go, Node.js и других языках, так что команду под проект подобрать можно. Но администрирование кластера, мониторинг отставания читателей и обновления становятся постоянной статьёй работ. Закладывайте их в поддержку сразу, а не после первого сбоя.
Проверить, что Kafka уже есть в вашем проекте, проще всего по документации и схеме инфраструктуры: в ней будут брокеры, топики и адреса вида kafka:9092. Порт 9092 используется в примерах официальной документации, на реальном сервере он может быть другим.
Kafka против RabbitMQ, порядок сообщений и повторы
Чем Kafka отличается от RabbitMQ на практике?
Kafka хранит события в журнале и даёт перечитывать их многим сервисам, а RabbitMQ раздаёт задания и удаляет их после подтверждения. Для фоновых задач сайта обычно хватает RabbitMQ, для больших потоков событий и аналитики в реальном времени выбирают Kafka.
Что гарантирует Apache Kafka относительно порядка сообщений?
Порядок Kafka гарантирует внутри одной партиции топика. Чтобы события одного заказа или клиента шли строго по очереди, им дают одинаковый ключ, и они попадают в одну партицию.
Сколько Kafka хранит сообщения после того, как их прочитали?
Столько, сколько задано в настройках хранения топика: по времени или по объёму. Чтение на срок не влияет, поэтому новый сервис может прочитать события, которые другие обработали неделю назад, если срок их хранения ещё не вышел.
Как Kafka не теряет и не задваивает сообщения при сбоях?
Kafka копирует партиции на несколько брокеров и умеет повторять отправку, если подтверждение не пришло. Для режима exactly once есть идемпотентная запись и транзакции, но гарантия работает, только если отправители и читатели правильно настроены, а внешние системы вроде CRM от дублей защищают отдельно.
Что нужно, чтобы подключить Kafka к сайту на 1С-Битрикс?
Сайт на 1С-Битрикс отправляет события в Kafka через PHP-клиент или через промежуточный сервис, а сам кластер Kafka работает отдельно. Для типового сайта это редко оправдано: заявки и заказы проще передавать через API или очередь.
Если проекту нужен обмен событиями между сайтом, CRM и учётными системами, начинаем с проектирования и анализа: считаем поток событий и выбираем инструмент по задаче. Если проект уже работает на Kafka, берём его на доработку и поддержку.
Источники
- Документация Apache Kafka: «Introduction», «Upgrading to 4.0»
- Документация RabbitMQ: «RabbitMQ vs. Apache Kafka»
Остались вопросы по теме «Apache Kafka»?
Напишите нам в Telegram или MAX. Ответит специалист, который отвечает за эту тему, или руководитель проектов в рабочее время.
 Отвечает по темеСергей ЧерняковWeb-разработчик
Над статьёй работали
Услуги
Услуги по теме
Посчитайте стоимость проекта за 2 минуты
Калькулятор соберёт смету по нашим тарифам: сайт, дизайн, интеграции и поддержка.